音声エージェントの構築
セッションのセットアップ
Section titled “セッションのセットアップ”デフォルトの OpenAIRealtimeWebRTC など、一部のトランスポート層は音声の入出力を自動的に処理します。OpenAIRealtimeWebSocket などのほかのトランスポート方式では、セッションの音声を自分で処理する必要があります。
import {  RealtimeAgent,  RealtimeSession,  TransportLayerAudio,} from '@openai/agents/realtime';
const agent = new RealtimeAgent({ name: 'My agent' });const session = new RealtimeSession(agent);const newlyRecordedAudio = new ArrayBuffer(0);
session.on('audio', (event: TransportLayerAudio) => {  // play your audio});
// send new audio to the agentsession.sendAudio(newlyRecordedAudio);基盤となるトランスポートが対応している場合、session.muted は現在のミュート状態を示し、session.mute(true | false) はマイクのキャプチャを切り替えます。OpenAIRealtimeWebSocket にはミュート機能が実装されていません。session.muted は null を返し、session.mute() は例外をスローします。そのため、WebSocket を使用する構成では、アプリケーション側でキャプチャを一時停止し、マイクを再び有効にするまで sendAudio() の呼び出しを停止してください。
セッション構成
Section titled “セッション構成”セッション自体の設定は、RealtimeSession を作成するときに、通常は model オプションと config オブジェクトを通じて行います。connect(...) は、任意のセッションフィールドではなく、認証情報、エンドポイント URL、既存の Realtime 通話への接続といった、接続時に関わる事項を指定するためのものです。
import { RealtimeAgent, RealtimeSession } from '@openai/agents/realtime';
const agent = new RealtimeAgent({  name: 'Greeter',  instructions: 'Greet the user with cheer and answer questions.',});
const session = new RealtimeSession(agent, {  model: 'gpt-realtime-2.1',  config: {    outputModalities: ['audio'],    reasoning: {      effort: 'low',    },    parallelToolCalls: true,    audio: {      input: {        format: 'pcm16',        transcription: {          model: 'gpt-live-transcribe',          delay: 'low',          prompt:            'A software support conversation about the OpenAI Agents SDK.',          keywords: ['OpenAI Agents SDK', 'RealtimeSession'],          languages: ['en', 'ja'],        },      },      output: {        format: 'pcm16',      },    },  },});
内部では、SDK がこの設定を Realtime の session.update 形式に正規化します。RealtimeSessionConfig に対応するプロパティがない元のセッションフィールドを指定する必要がある場合は、providerData を使用するか、session.transport.sendEvent(...) を通じて元の session.update を送信してください。
outputModalities、audio.input、audio.output を使用する新しい SDK 設定形式を優先してください。modalities、inputAudioFormat、outputAudioFormat、inputAudioTranscription、turnDetection など、SDK の古いエイリアスも後方互換性のために引き続き正規化されますが、新しいコードではここに示すネストされた audio 構造を使用してください。
gpt-realtime-2.1 などの推論に対応した Realtime モデルでは、セッション設定で reasoning.effort を指定します。推論の労力を高くすると、レイテンシーとトークン使用量が増加する可能性があります。また、モデルが複数のツールを並列に呼び出せるかどうかを制御したい場合は、parallelToolCalls を設定できます。
入力音声の文字起こしでは、audio.input.transcription に一般提供(GA)されている文字起こしモデルと、そのコンテキストオプションを指定できます。低レイテンシーのストリーミング文字起こしには gpt-live-transcribe を使用してください。このモデルの delay 設定は、途中の文字起こし結果を返す速さと、最終的な文字起こしの品質とのトレードオフを調整します。gpt-live-transcribe と gpt-transcribe はどちらも、自由形式の prompt、そのままの語句を指定する keywords、languages 配列を受け付けます。これらのモデルでは languages を使用します。言語のヒントを 1 つ受け付ける従来の文字起こしモデルでは、引き続き単数形の language フィールドを使用します。モデルごとのワークフローについては、公式の文字起こしのコンテキストに関するガイダンスと Realtime 文字起こしガイドを参照してください。
音声から音声へのセッションでは、通常は outputModalities: ['audio'] を選択します。これにより、音声出力と文字起こしが得られます。テキストのみの応答が必要な場合に限り、['text'] に切り替えてください。
新しいパラメーターで、RealtimeSessionConfig に対応するパラメーターがない場合は、providerData を使用できます。providerData に渡した内容はすべて、元の session オブジェクトの一部として転送されます。
作成時に設定できる、そのほかの RealtimeSession オプションは次のとおりです。
| オプション | 型 | 用途 |
|---|---|---|
context | TContext | セッションコンテキストにマージする追加のローカルコンテキスト。 |
historyStoreAudio | boolean | ローカルの履歴スナップショットに音声データを保存します(デフォルトでは無効)。 |
outputGuardrails | RealtimeOutputGuardrail[] | セッションの出力ガードレール(ガードレールを参照)。 |
outputGuardrailSettings | { debounceTextLength?: number } | ガードレールの実行間隔。デフォルトは 100 です。完全なテキストが利用可能になった時点でのみ実行するには、-1 を使用します。 |
tracingDisabled | boolean | セッションのトレーシングを無効にします。 |
groupId | string | 複数のセッションやバックエンド実行にわたるトレースをグループ化します。workflowName が必要です。 |
traceMetadata | Record<string, any> | セッショントレースに付加するカスタムメタデータ。workflowName が必要です。 |
workflowName | string | トレースのワークフローに付けるわかりやすい名前。 |
automaticallyTriggerResponseForMcpToolCalls | boolean | MCPツールの呼び出しが完了したときに、モデルの応答を自動的にトリガーします(デフォルト:true)。 |
toolErrorFormatter | ToolErrorFormatter | モデルに返すツール承認の拒否メッセージをカスタマイズします。 |
toolExecution | RealtimeToolExecutionConfig | ローカルのリアルタイム関数ツールに対する SDK 側の実行設定。承認待ちリクエストを発行する前に入力ガードレールを実行するには、preApprovalInputGuardrails: true を設定します。 |
connect(...) のオプションは次のとおりです。
| オプション | 型 | 用途 |
|---|---|---|
apiKey | string | (() => string | Promise<string>) | この接続に使用する API キー(または遅延ローダー)。 |
model | OpenAIRealtimeModels | string | トランスポートレベルのオプション型に含まれます。RealtimeSession では、コンストラクターでモデルを設定してください。トランスポートを直接使用する場合は、接続時にモデルを指定することもできます。 |
url | string | 任意のカスタム Realtime エンドポイント URL。 |
callId | string | WebRTC または SIP で確立された通話を含む既存の Realtime 通話に、WebSocket トランスポートをサイドバンド接続として接続します。 |
会話のライフサイクル
Section titled “会話のライフサイクル”RealtimeSession は、長時間維持される Realtime 接続の上で動作します。会話履歴のローカルコピーを保持し、トランスポートイベントを監視し、ツールと出力ガードレールを実行し、アクティブなエージェントの設定をトランスポートと同期させます。
基盤となる API の動作にも引き続き注意が必要です。
- 接続に成功すると
session.createdイベントで始まり、その後の設定変更ではsession.updatedが発生します。 - ほとんどのセッションプロパティは後から変更できますが、
modelは会話の途中では変更できず、voiceはセッションが音声出力を生成する前にしか変更できません。また、Realtime APIではトレーシングを有効にした後に変更できないため、トレーシングについては事前に決めておく必要があります。 - Realtime APIでは現在、1 つのセッションの長さが 60 分に制限されています。
- 入力音声の文字起こしは非同期で行われるため、直近の発話の文字起こしが、応答の生成開始後に届くことがあります。
SDK 層では、await session.connect() は「会話を開始できるだけの準備がトランスポートで整った」ことを意味しますが、正確なタイミングはトランスポートによって異なります。
- デフォルトのブラウザー向け WebRTC トランスポートでは、データチャネルが開くとすぐに SDK が最初の
session.updateを送信し、対応するsession.updatedイベントを待ってからconnect()を完了しようとします。WebRTC トランスポートがこの確認応答を待つのは、instructions、tools、モダリティが適用される前に音声がサーバーへ届くことを防ぐためです。確認応答が届かない場合、connect()は短いタイムアウトの後に完了します。 - デフォルトのサーバー側 WebSocket トランスポートでは、ソケットが開いて初期設定が送信されると
connect()が完了します。そのため、対応するsession.updatedイベントは、connect()の完了後に届くことがあります。
元のイベントモデルが必要な場合は、このページとあわせて公式の Realtime 会話ガイドを参照してください。
対話のフロー
Section titled “対話のフロー”ターン検出と音声アクティビティ検出
Section titled “ターン検出と音声アクティビティ検出”デフォルトでは、Realtime セッションは組み込みの音声アクティビティ検出(VAD)を使用します。これにより、API はユーザーが話し始めたタイミング、話し終えたタイミング、応答を作成するタイミングを判断できます。SDK では、audio.input.turnDetection を通じてこの機能を利用できます。
import { RealtimeSession } from '@openai/agents/realtime';import { agent } from './agent';
const session = new RealtimeSession(agent, {  model: 'gpt-realtime-2.1',  config: {    audio: {      input: {        turnDetection: {          type: 'semantic_vad',          eagerness: 'medium',          createResponse: true,          interruptResponse: true,        },      },    },  },});
一般的な 2 つのモードは次のとおりです。
semantic_vadは、より自然なターンの区切りを目指すもので、ユーザーがまだ話し終えていないように聞こえる場合は、少し長く待つことがあります。server_vadは、よりしきい値に基づいて動作し、threshold、prefixPaddingMs、silenceDurationMs、idleTimeoutMsなどの設定を提供します。
ターンの区切りを自分で管理する場合は、audio.input.turnDetection を null に設定してください。基盤となる動作の詳細については、公式の音声アクティビティ検出ガイドと Realtime 会話ガイドを参照してください。
VAD が有効な場合、エージェントが話している間にユーザーが話すと、現在の応答に割り込むことができます。WebSocket トランスポートでは、SDK が input_audio_buffer.speech_started を監視し、アシスタントの音声をユーザーが実際に聞いた部分までに切り詰め、audio_interrupted イベントを発行します。このイベントは、WebSocket を使用する構成で再生を自分で管理する場合に特に役立ちます。
import { session } from './agent';
session.on('audio_interrupted', () => { // handle local playback interruption});手動の停止ボタンを提供したい場合は、interrupt() を自分で呼び出してください。
import { session } from './agent';
session.interrupt();// This still triggers `audio_interrupted` so your UI can stop playback
WebRTC と WebSocket はどちらも進行中の応答を停止しますが、低レベルの仕組みはトランスポートによって異なります。WebRTC は、バッファー内の出力音声を自動的にクリアします。WebSocket を使用する構成では、ローカルでの再生を自分で停止する必要があります。また、対応する切り詰めイベントと会話イベントがトランスポートから返されると、ローカルの履歴が更新されます。
テキスト入力
Section titled “テキスト入力”入力されたテキストや追加の構造化されたユーザーコンテンツを進行中の会話に送信するには、sendMessage() を使用します。
import { RealtimeSession, RealtimeAgent } from '@openai/agents/realtime';
const agent = new RealtimeAgent({  name: 'Assistant',});
const session = new RealtimeSession(agent, {  model: 'gpt-realtime-2.1',});
session.sendMessage('Hello, how are you?');
これは、テキストと音声を組み合わせた UI、通常の対話とは別経路でのコンテキストの挿入、音声入力に明示的なテキストの補足を組み合わせる場合に役立ちます。
Realtime の音声から音声へのセッションには、画像を含めることもできます。SDK では、addImage() を使用して現在の会話に画像を添付します。
import { RealtimeAgent, RealtimeSession } from '@openai/agents/realtime';
const agent = new RealtimeAgent({  name: 'Assistant',});
const session = new RealtimeSession(agent, {  model: 'gpt-realtime-2.1',});
const imageDataUrl = 'data:image/png;base64,...';
session.addImage(imageDataUrl, { triggerResponse: false });session.sendMessage('Describe what is in this image.');
triggerResponse: false を渡すと、モデルに応答を求める前に、画像を後続のテキストや音声のターンとまとめることができます。これは、公式の Realtime 会話における画像入力のガイダンスに沿った動作です。
応答の手動制御
Section titled “応答の手動制御”上位の SDK 層では、sendMessage() と addImage() はデフォルトで応答をトリガーします。応答の手動制御が重要になるのは、元のトランスポートイベント、プッシュトゥトークのフロー、カスタムのモデレーションや検証手順を扱う場合です。
import { RealtimeAgent, RealtimeSession } from '@openai/agents/realtime';
const agent = new RealtimeAgent({  name: 'Greeter',  instructions: 'Greet the user with cheer and answer questions.',});
const session = new RealtimeSession(agent, {  model: 'gpt-realtime-2.1',});
session.transport.on('*', (event) => {  // Event received from the underlying Realtime transport});
// Send any valid client event, for example, to trigger a new responsesession.transport.sendEvent({  type: 'response.create',  // ...});
一般的なケースは 2 つあります。
audio.input.turnDetection = nullで VAD を完全に無効にした場合は、音声ターンをコミットしてからresponse.createを送信する処理を自分で行う必要があります。- VAD を有効にしたまま、
turnDetection.interruptResponse = falseとturnDetection.createResponse = falseを設定した場合、API は引き続きターンを検出しますが、応答の作成は自分で制御します。
VAD を有効にしたまま、turnDetection.interruptResponse と turnDetection.createResponse の両方を false に設定すると、モデルが応答する前にユーザー入力を検査したり、モデレーションしたりしたい場合に役立ちます。この設定は、公式の Realtime 会話における自動応答の無効化に関するガイダンスに沿ったものです。
エージェントの機能
Section titled “エージェントの機能”通常のエージェントと同様に、ハンドオフを使用してエージェントを複数のエージェントに分割し、それらの間で処理を調整することで、パフォーマンスを向上させ、問題の範囲をより適切に絞り込むことができます。
import { RealtimeAgent } from '@openai/agents/realtime';
const mathTutorAgent = new RealtimeAgent({  name: 'Math Tutor',  handoffDescription: 'Specialist agent for math questions',  instructions:    'You provide help with math problems. Explain your reasoning at each step and include examples',});
const agent = new RealtimeAgent({  name: 'Greeter',  instructions: 'Greet the user with cheer and answer questions.',  handoffs: [mathTutorAgent],});
音声エージェントのハンドオフは、通常のエージェントとは動作が少し異なります。ハンドオフが行われると、進行中のセッションが、その場で新しいエージェントの設定に更新されます。このため、新しいエージェントは進行中の会話履歴に自動的にアクセスでき、現時点では入力フィルターは適用されません。
セッションは維持されるため、ハンドオフ中にそのセッションのモデルが変わることはありません。音声の変更には、基盤となるRealtime APIのルールが適用されます。つまり、セッションが音声出力を生成する前にのみ変更できます。Realtime のハンドオフは、主に同じセッション上で RealtimeAgent の設定を切り替えるためのものです。gpt-5.4 のような推論モデルなど、別のモデルを使用する必要がある場合や、リアルタイムではないバックエンドエージェントに委譲する場合は、ツールを通じた委譲を使用してください。
通常のエージェントと同様に、音声エージェントもツールを呼び出してアクションを実行できます。Realtime は、 関数ツール (ローカルで実行)と ホスト型MCPツール (Realtime APIによってリモートで実行)に対応しています。関数ツールは、通常のエージェントと同じ tool() ヘルパーを使用して定義できます。
Responses 専用のツールオプションは、音声エージェントには引き継がれません。関数ツールの outputSchema と、'programmatic' を含む allowedCallers の値は拒否されます。ホスト型MCPツールのプログラムによる呼び出し元も同様です。Realtime セッションでは直接呼び出せる関数ツールまたはホスト型MCPツールを使用するか、Programmatic Tool Calling が必要な処理を Responses エージェントに委譲してください。
import { tool, RealtimeAgent } from '@openai/agents/realtime';import { z } from 'zod';
const getWeather = tool({  name: 'get_weather',  description: 'Return the weather for a city.',  parameters: z.object({ city: z.string() }),  async execute({ city }) {    return `The weather in ${city} is sunny.`;  },});
const weatherAgent = new RealtimeAgent({ name: 'Weather assistant', instructions: 'Answer weather questions.', tools: [getWeather],});関数ツールは、RealtimeSession と同じ環境で実行されます。つまり、セッションをブラウザーで実行している場合、ツールもブラウザーで実行されます。機密性の高い操作を行う必要がある場合は、ツール内からバックエンドを呼び出し、権限が必要な処理はサーバーに任せてください。
これにより、ブラウザー側のツールを、サーバー側のロジックにつながる薄いバックチャネルとして機能させることができます。たとえば、examples/realtime-next では、ブラウザー内に refundBackchannel ツールを定義しています。このツールは、リクエストと現在の会話履歴をサーバー上の handleRefundRequest(...) に転送します。サーバーでは、別の Runner が異なるエージェントやモデルを使用して返金を評価してから、結果を音声セッションに返すことができます。
ホスト型MCPツール
Section titled “ホスト型MCPツール”ホスト型MCPツールは hostedMcpTool で設定でき、リモートで実行されます。MCPツールの利用可能な状態が変わると、セッションは mcp_tools_changed を発行します。MCPツールの呼び出し完了後に、セッションがモデルの応答を自動的にトリガーしないようにするには、automaticallyTriggerResponseForMcpToolCalls: false を設定してください。
フィルター適用後の現在のMCPツール一覧は、session.availableMcpTools からも取得できます。このプロパティと mcp_tools_changed イベントのどちらにも、エージェント設定の allowed_tools フィルターを適用したうえで、アクティブなエージェントで有効になっているホスト型MCPサーバーのみが反映されます。
ホスト型MCPのセットアップは、安全なサーバーの選択、ヘッダー、承認を接続前の設定として扱うと、理解しやすくなります。RealtimeSession.connect() がトランスポートを開く前に、SDK はアクティブなエージェントのホスト型MCPツール定義を解決し、対応しているMCPフィールドを、Realtime APIに送信する初期セッション設定に含めます。
connect() の前に安全なホスト型MCP設定を指定することは、ブラウザーの WebRTC アプリで特に重要です。一時的なクライアントシークレットは必ずサーバーで発行するため、秘密にしておく必要があるホスト型MCPの認証情報やカスタム headers は、サーバー側の POST /v1/realtime/client_secrets リクエストで、初期 session ペイロードの一部として付加してください。長期間有効な認証情報をブラウザーコードに含め、connect() の開始後に追加する設計にはしないでください。
Realtime APIのレベルでは、後続の session.update 呼び出しでもツールやその他の変更可能なセッションフィールドを変更できます。また、アクティブなエージェントが変わると、SDK 自体も session.update を送信します。ただし、ブラウザーアプリでは、安全なホスト型MCPの初期化をサーバー側の接続前の処理として扱い、ブラウザー側の RealtimeSession 設定を、サーバーで発行した内容と一致させてください。
バックグラウンドの結果
Section titled “バックグラウンドの結果”ツールの実行中、エージェントはユーザーからの新しいリクエストを処理できません。体験を改善する方法の 1 つは、ツールを実行する直前にその旨を伝えたり、特定のフレーズを話してツールの実行時間を確保したりするよう、エージェントに指示することです。
関数ツールの完了直後に次のモデル応答をトリガーしたくない場合は、@openai/agents/realtime の backgroundResult(output) を返してください。これにより、応答をトリガーするタイミングを自分で制御しながら、ツールの出力をセッションに返すことができます。
タイムアウト
Section titled “タイムアウト”関数ツールのタイムアウトオプション(timeoutMs、timeoutBehavior、timeoutErrorFunction)は、Realtime セッションでも同じように動作します。デフォルトの error_as_result では、タイムアウトメッセージがツールの出力として送信されます。raise_exception では、セッションが ToolTimeoutError を伴う error イベントを発行し、その呼び出しのツール出力は送信しません。
会話履歴へのアクセス
Section titled “会話履歴へのアクセス”エージェントが特定のツールを呼び出す際に渡した引数に加えて、Realtime セッションが追跡している現在の会話履歴のスナップショットにもアクセスできます。これは、会話の現在の状態に基づいてより複雑なアクションを実行する必要がある場合や、ツールを使用した委譲を計画している場合に役立ちます。
import {  tool,  RealtimeContextData,  RealtimeItem,} from '@openai/agents/realtime';import { z } from 'zod';
const parameters = z.object({  request: z.string(),});
const refundTool = tool<typeof parameters, RealtimeContextData>({ name: 'Refund Expert', description: 'Evaluate a refund', parameters, execute: async ({ request }, details) => { // The history might not be available const history: RealtimeItem[] = details?.context?.history ?? []; // Call your backend to process the refund request },});ツール実行前の承認
Section titled “ツール実行前の承認”ツールを needsApproval: true で定義すると、エージェントはツールを実行する前に tool_approval_requested イベントを発行します。
このイベントを監視することで、ツール呼び出しを承認または拒否する UI をユーザーに表示できます。
リクエストは、await session.approve(request.approvalItem) または await session.reject(request.approvalItem) で解決します。関数ツールでは、{ alwaysApprove: true } または { alwaysReject: true } を渡すと、セッションの残りの間、繰り返される呼び出しに同じ判断を再利用できます。また、session.reject(request.approvalItem, { message: '...' }) を使用すると、その呼び出しについてカスタムの拒否メッセージをモデルに返せます。ホスト型MCPの承認では、承認や拒否の判断を継続して適用することはできません。代わりに、ホスト型MCPの allowedTools 設定でツールを制限してください。
呼び出しごとの拒否 message を渡さない場合、セッションは toolErrorFormatter(設定されている場合)を使用し、それもなければ SDK のデフォルトの拒否テキストを使用します。
デフォルトでは、関数ツールの入力ガードレールは承認後、ツールの実行直前に実行されます。new RealtimeSession(...) に toolExecution: { preApprovalInputGuardrails: true } を渡すと、ローカルの関数ツールの入力ガードレールは、セッションが tool_approval_requested を発行する前にも実行されます。ガードレールが呼び出しを拒否した場合は、拒否メッセージをツール出力として返し、承認イベントはスキップします。ガードレールが呼び出しを許可した場合は、引き続き承認イベントが発行され、session.approve(...) の後、実行前にガードレールが再び実行されます。
import { session } from './agent';
session.on('tool_approval_requested', (_context, _agent, request) => {  // Show a UI to let the user approve or reject the tool call  // Then resolve the request with `session.approve(...)` or `session.reject(...)`
session.approve(request.approvalItem);});ガードレール
Section titled “ガードレール”ガードレールは、エージェントが発言した内容が一連のルールに違反していないかを監視し、応答を即座に打ち切る方法を提供します。これらのチェックは、エージェントの応答の出力ストリームに対して実行されます。テキストのみのセッションでは、SDK は出力テキストの差分を評価します。音声セッションでは、出力音声の文字起こしとその差分を使用するため、重要な前提条件は、別個のテキスト出力モダリティではなく、文字起こしが利用可能であることです。
指定したガードレールは、モデルの応答が返されるのと並行して非同期に実行されます。これにより、たとえば「特定の禁止語に言及している」といった、事前定義した分類トリガーに基づいて応答を打ち切ることができます。
ガードレールが作動すると、セッションは guardrail_tripped イベントを発行します。このイベントには、ガードレールを作動させた itemId を含む details オブジェクトも含まれます。
import {  RealtimeOutputGuardrail,  RealtimeAgent,  RealtimeSession,} from '@openai/agents/realtime';
const agent = new RealtimeAgent({  name: 'Greeter',  instructions: 'Greet the user with cheer and answer questions.',});
const guardrails: RealtimeOutputGuardrail[] = [  {    name: 'No mention of Dom',    async execute({ agentOutput }) {      const domInOutput = agentOutput.includes('Dom');      return {        tripwireTriggered: domInOutput,        outputInfo: { domInOutput },      };    },  },];
const guardedSession = new RealtimeSession(agent, {  outputGuardrails: guardrails,});
デフォルトでは、ガードレールは 100 文字ごとに実行され、最終的な文字起こしが利用可能になった時点でも再度実行されます。通常、テキストを話すには文字起こしを生成するよりも時間がかかるため、多くの場合、ユーザーが聞く前にガードレールが安全でない出力を打ち切ることができます。
この動作を変更したい場合は、セッションに outputGuardrailSettings オブジェクトを渡します。
応答の最後に、完全に生成された文字起こしを一度だけ評価したい場合は、debounceTextLength: -1 を設定してください。
import { RealtimeAgent, RealtimeSession } from '@openai/agents/realtime';
const agent = new RealtimeAgent({  name: 'Greeter',  instructions: 'Greet the user with cheer and answer questions.',});
const guardedSession = new RealtimeSession(agent, {  outputGuardrails: [    /*...*/  ],  outputGuardrailSettings: {    debounceTextLength: 500, // run guardrail every 500 characters or set it to -1 to run it only at the end  },});
会話の状態と委譲
Section titled “会話の状態と委譲”会話履歴の管理
Section titled “会話履歴の管理”RealtimeSession は、ユーザーメッセージ、アシスタントの出力、ツール呼び出し、切り詰めの状態を追跡するローカルの history スナップショットを自動的に維持します。これを UI に表示したり、ツール内で確認したり、項目の修正や削除が必要なときに更新したりできます。
会話が変化すると、セッションは history_updated を発行します。履歴の変更をリクエストする必要がある場合は、updateHistory() を使用してください。これはトランスポートに対して、現在の履歴との差分を取り、必要な削除・作成イベントを送信するよう求めます。対応する会話イベントが返されると、ローカルの session.history の内容が更新されます。
import { RealtimeSession, RealtimeAgent } from '@openai/agents/realtime';
const agent = new RealtimeAgent({  name: 'Assistant',});
const session = new RealtimeSession(agent, {  model: 'gpt-realtime-2.1',});
await session.connect({ apiKey: '<client-api-key>' });
// listening to the history_updated eventsession.on('history_updated', (history) => {  // returns the full history of the session  console.log(history);});
// Option 1: explicit settingsession.updateHistory([  /* specific history */]);
// Option 2: override based on current state like removing all agent messagessession.updateHistory((currentHistory) => { return currentHistory.filter( (item) => !(item.type === 'message' && item.role === 'assistant'), );});- 現時点では、関数ツールの呼び出しを事後に編集することはできません。
- 履歴内のアシスタントのテキストは、
output_audio.transcriptを含む、利用可能な文字起こしに依存します。 - 割り込みによって切り詰められた応答には、最終的な文字起こしが保持されません。
- 入力音声の文字起こしは、モデルが音声をどのように解釈したかを正確に写したものではなく、ユーザーの発言内容のおおよその目安として扱うのが適切です。
ツールを通じた委譲
Section titled “ツールを通じた委譲”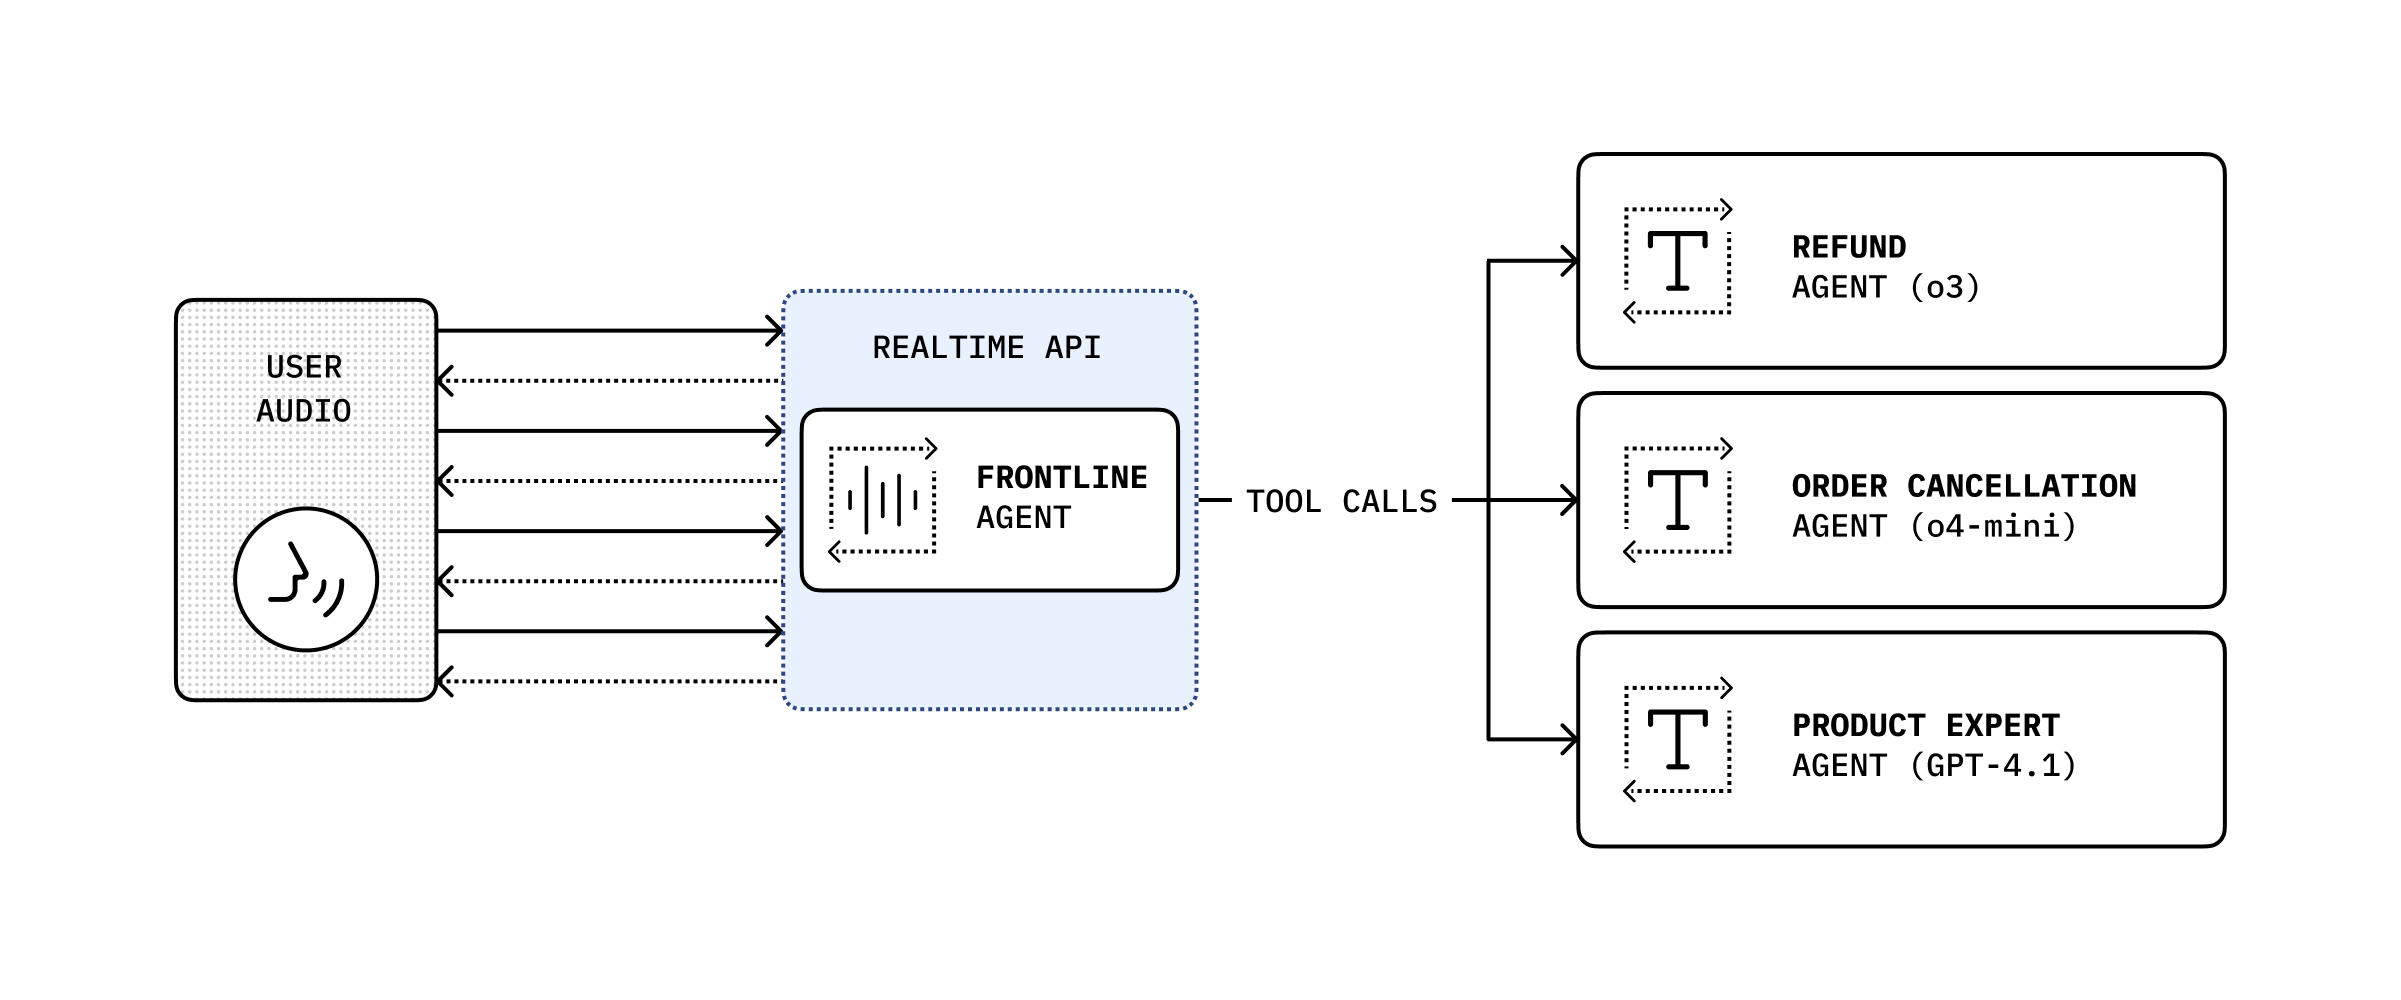
会話履歴とツール呼び出しを組み合わせることで、会話を別のバックエンドエージェントに委譲し、より複雑なアクションを実行してから、その結果をユーザーに返すことができます。
import {  RealtimeAgent,  RealtimeContextData,  tool,} from '@openai/agents/realtime';import { handleRefundRequest } from './serverAgent';import z from 'zod';
const refundSupervisorParameters = z.object({  request: z.string(),});
const refundSupervisor = tool<  typeof refundSupervisorParameters,  RealtimeContextData>({  name: 'escalateToRefundSupervisor',  description: 'Escalate a refund request to the refund supervisor',  parameters: refundSupervisorParameters,  execute: async ({ request }, details) => {    // This will execute on the server    return handleRefundRequest(request, details?.context?.history ?? []);  },});
const agent = new RealtimeAgent({  name: 'Customer Support',  instructions:    'You are a customer support agent. If you receive any requests for refunds, you need to delegate to your supervisor.',  tools: [refundSupervisor],});
続いて、以下のコードがサーバー上で実行されます。この例では、Next.js の Server Action を使用しています。
// This runs on the serverimport 'server-only';
import { Agent, run } from '@openai/agents';import type { RealtimeItem } from '@openai/agents/realtime';import z from 'zod';
const agent = new Agent({  name: 'Refund Expert',  instructions:    'You are a refund expert. You are given a request to process a refund and you need to determine if the request is valid.',  model: 'gpt-5.4',  outputType: z.object({    reason: z.string(),    refundApproved: z.boolean(),  }),});
export async function handleRefundRequest(  request: string,  history: RealtimeItem[],) {  const input = `The user has requested a refund.
The request is: ${request}
Current conversation history:${JSON.stringify(history, null, 2)}`.trim();
  const result = await run(agent, input);
  return JSON.stringify(result.finalOutput, null, 2);}